Использовать ИИ в работе хочется всё чаще, но для бизнеса отправка информации во внешнее облако несёт серьезные риски, особенно когда речь идёт о клиентских данных, коммерческой тайне или внутренних документах.
Локальный ИИ может стать решением, но здесь легко ошибиться с выбором модели и оборудования. Не для каждой задачи нужна мощная видеокарта, а небольшая модель не всегда сможет заменить облачный ИИ.
Ринат Минязев, инженер-программист с более чем 15 годами опыта работы с вычислительными кластерами на Linux, кандидат технических наук и автор курсов на Stepik, разбирается, где локальный ИИ действительно полезен бизнесу, а где лучше остановиться на облачном. В статье он показывает, какие задачи можно решать локально, какие модели для этого подходят и сколько видеопамяти потребуется.
2026-й — первый год, когда локальный ИИ перестал быть уделом только крупных компаний. Видеокарта за полторы-две тысячи долларов уже тянет модели, которые в бенчмарках приближаются к топовым облачным. При этом отдавать документы и данные клиентов в чужое облако для обработки и получения ответов от ИИ мешают и коммерческая тайна и 152-ФЗ.
За решением «поставить локальный ИИ» скрываются два главных вопроса: решает ли он именно вашу задачу и что конкретно для этого нужно купить. В статье разберем ситуации, где локальный ИИ помогает, и под каждую задачу посмотрим, какого класса модель её закрывает и какая видеокарта под неё нужна. В конце — сводная таблица и раздел о том, где локальный ИИ разворачивать не стоит.
За решением «поставить локальный ИИ» скрываются два главных вопроса: решает ли он именно вашу задачу и что конкретно для этого нужно купить. В статье разберем ситуации, где локальный ИИ помогает, и под каждую задачу посмотрим, какого класса модель её закрывает и какая видеокарта под неё нужна. В конце — сводная таблица и раздел о том, где локальный ИИ разворачивать не стоит.
ВНИМАНИЕ: вся информация ниже - частное мнение автора на основе своего опыта!
Сначала честно: где локальный ИИ выигрывает, а где проигрывает
Локальные модели в 2026-м сильны, но они уступают фронтирам (ChatGPT, Deepseek, Qwen и другие). Их главная сила в том, что вы можете их донастроить под свои задачи: загрузить свои файлы, задать нужный системный промт в модели и так далее.
Практический ориентир: хорошая локальная модель на 14 миллиардов параметров даёт примерно 70–80% качества облачного фронтира на большинстве прикладных задач. Разрыв заметнее всего на сложных многошаговых рассуждениях и на творческом письме. Что это значит на практике:
Главный выигрыш локального ИИ не «качество любой ценой», а то, что данные не покидают ваш периметр, нет ежемесячной платы за каждого сотрудника и нет зависимости от VPN и лимитов.
Практический ориентир: хорошая локальная модель на 14 миллиардов параметров даёт примерно 70–80% качества облачного фронтира на большинстве прикладных задач. Разрыв заметнее всего на сложных многошаговых рассуждениях и на творческом письме. Что это значит на практике:
- Рутинные офисные задачи — суммаризация, деловые письма, ответы по внутренней базе знаний, обработка документов — локальная модель закрывает практически на уровне облака. Здесь вы почти ничего не теряете.
- Сложный анализ и многоступенчатые рассуждения — тут облако пока сильнее, и под такие задачи нужна модель покрупнее (а значит, более мощная видеокарта) либо разумное сочетание с облаком для несекретных случаев.
Главный выигрыш локального ИИ не «качество любой ценой», а то, что данные не покидают ваш периметр, нет ежемесячной платы за каждого сотрудника и нет зависимости от VPN и лимитов.
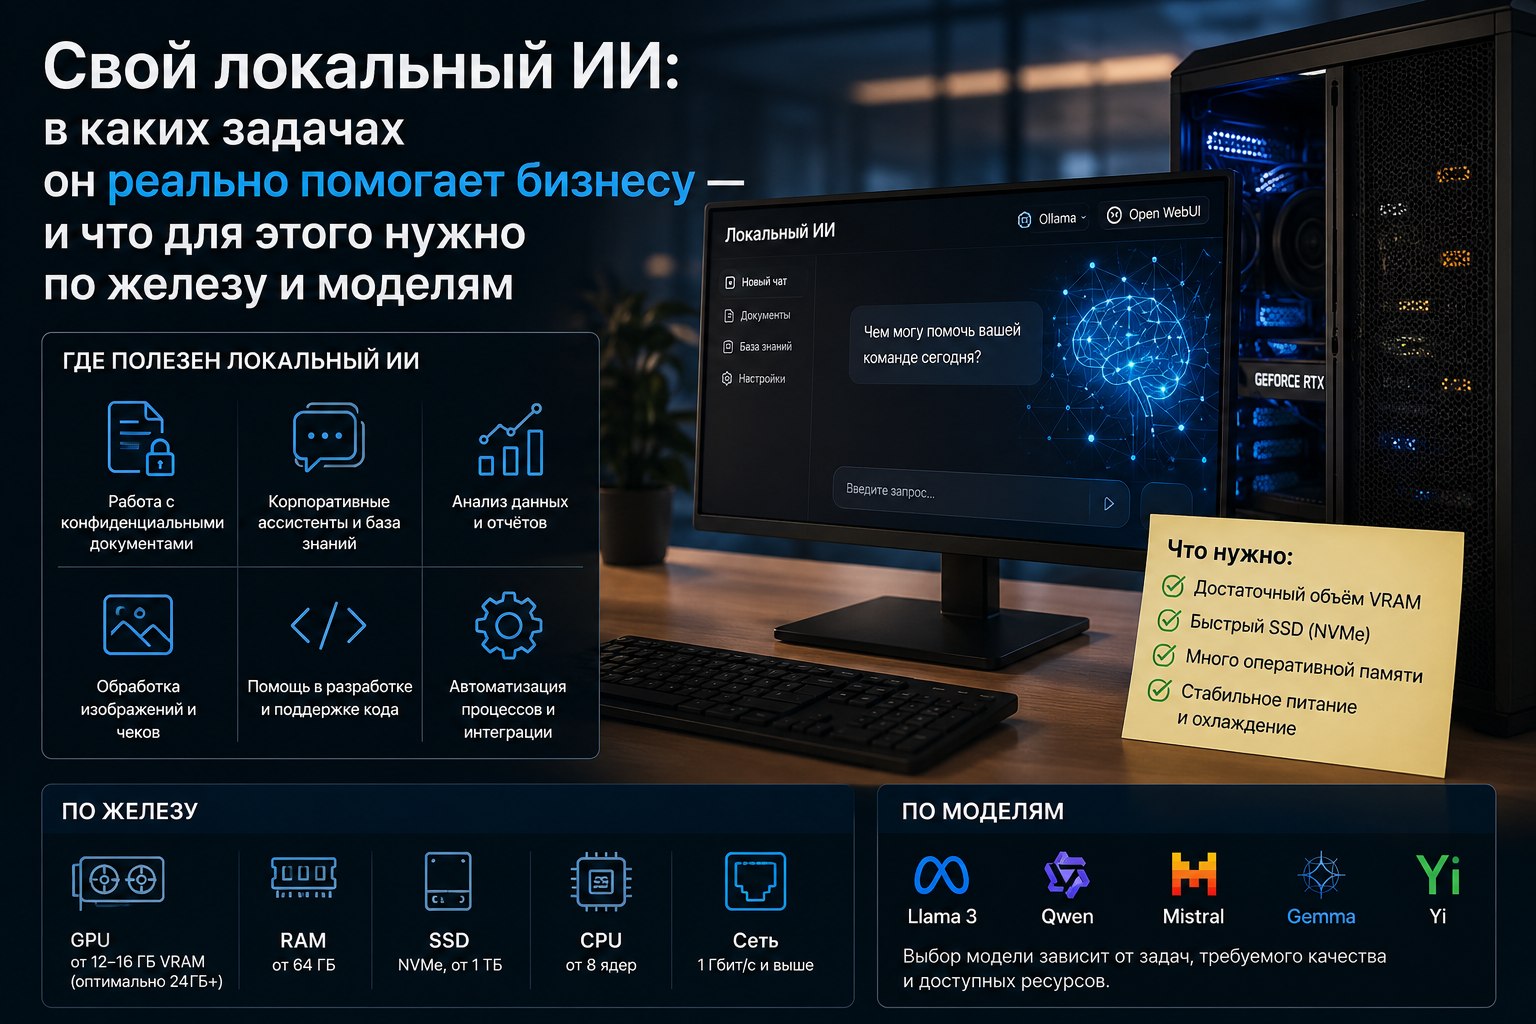
Важный принцип, который нужно помнить при подборе железа: всё решает видеопамять (VRAM). Локальная модель почти целиком живёт в памяти видеокарты. Сколько у вас VRAM — модель такого размера вы и запустите с комфортной скоростью. Поэтому под каждую задачу я указываю не только модель, но и требуемый объём видеопамяти — это главный параметр.
Ситуация 1. Работа с офисными документами
Кому: практически любой компании — юристам, бухгалтерии, менеджерам, аналитикам.
Суммаризация длинных документов, извлечение сути из PDF и Word, черновики деловых писем, ответы на вопросы по внутренним регламентам, первичная обработка таблиц. Это самый массовый и самый выгодный сценарий: именно здесь локальная модель почти не уступает облаку, а данные при этом не уходят наружу.
Модель: класс 7–14B. Актуальные примеры на середину 2026 — Qwen 14B как универсал, Gemma 12B, Phi-4, Llama 8B. (Названия версий меняются — перед запуском сверяйте актуальные теги в библиотеке Ollama.)
Видеокарта: 16 ГБ VRAM. Это карта уровня RTX 5060 Ti 16 ГБ (≈ 50 000 ₽) или 5070 Ti 16 ГБ (≈ 92 000 ₽). Сервер целиком под такую задачу собирается в районе 150 000 ₽.
Видеокарта: 16 ГБ VRAM. Это карта уровня RTX 5060 Ti 16 ГБ (≈ 50 000 ₽) или 5070 Ti 16 ГБ (≈ 92 000 ₽). Сервер целиком под такую задачу собирается в районе 150 000 ₽.
Ситуация 2. Чат-бот поддержки по вашим документам
Кому: компаниям с большой базой знаний, инструкций, регламентов — поддержка, HR, внутренний help desk.
Бот, который отвечает сотрудникам или клиентам на основе именно ваших материалов, а не общих знаний из интернета. Технически это модель плюс поиск по вашей базе (так называемый RAG) — вопросы сотрудников не уходят в облако, а ответы опираются на ваши документы.
Модель: та же 7–14B плюс отдельная embedding-модель для поиска по базе (например, nomic-embed-text — она лёгкая и почти не добавляет нагрузки).
Видеокарта: 16 ГБ VRAM хватает. Тот же класс железа, что и в первой ситуации, — сервер от ~150 000 ₽.
Видеокарта: 16 ГБ VRAM хватает. Тот же класс железа, что и в первой ситуации, — сервер от ~150 000 ₽.
Ситуация 3. Анализ договоров и содержательный разбор документов
Кому: юрфирмам, отделам закупок, финансистам, комплаенсу.
Здесь уже не «перескажи», а «разбери»: найди риски в договоре, сравни версии, выдели нестандартные условия. Это ближе к тем самым многоступенчатым рассуждениям, где нужна модель покрупнее, чтобы не терять качество на нюансах.
Модель: класс 32B. Примеры на середину 2026 — Qwen 32B, для задач с упором на логику — DeepSeek-R1 в 32B-варианте.
Видеокарта: 32 ГБ VRAM. Это уровень RTX 5090 32 ГБ (≈ 320 000–350 000 ₽); сервер целиком выходит в диапазон 400 000–500 000 ₽. Такая карта тянет 32B-модель комфортно, держит большой контекст и позволяет держать в памяти несколько моделей сразу.
Видеокарта: 32 ГБ VRAM. Это уровень RTX 5090 32 ГБ (≈ 320 000–350 000 ₽); сервер целиком выходит в диапазон 400 000–500 000 ₽. Такая карта тянет 32B-модель комфортно, держит большой контекст и позволяет держать в памяти несколько моделей сразу.
Ситуация 4. Помощник по коду для команды разработки
Кому: ИТ-командам и продуктовым компаниям, которым нужен приватный ассистент по коду без утечки исходников в облако.
Автодополнение, ревью, объяснение и рефакторинг кода — всё внутри периметра, ваш код не покидает компанию.
Модель: специализированные кодовые модели. Текущий сильный локальный вариант — qwen3-coder на 30B (это MoE-модель, весит около 19 ГБ, держит очень большой контекст). Для более лёгкого железа есть кодовые модели в 7B.
Видеокарта: для 30B-кодовой модели комфортны 24–32 ГБ — то есть RTX 5090 32 ГБ. Для лёгкого варианта (7B) хватит 16 ГБ.
Видеокарта: для 30B-кодовой модели комфортны 24–32 ГБ — то есть RTX 5090 32 ГБ. Для лёгкого варианта (7B) хватит 16 ГБ.
Ситуация 5. Распознавание изображений и сканов
Кому: тем, кто работает с бумажными документами, фото, скан-копиями — бухгалтерия, документооборот, логистика.
Описание изображений, извлечение текста и данных со сканов, разбор фотографий документов. Для этого нужны отдельные vision-модели — они «видят» картинку, а не только текст.
Модель: мультимодальные модели. Примеры — Gemma с нативной поддержкой изображений, llava и подобные.
Видеокарта: зависит от размера модели, ориентир — от 16 ГБ (базовые задачи) до 32 ГБ (крупнее и точнее). То есть от RTX 5060 Ti 16 ГБ до RTX 5090 32 ГБ.
Описание изображений, извлечение текста и данных со сканов, разбор фотографий документов. Для этого нужны отдельные vision-модели — они «видят» картинку, а не только текст.
Модель: мультимодальные модели. Примеры — Gemma с нативной поддержкой изображений, llava и подобные.
Видеокарта: зависит от размера модели, ориентир — от 16 ГБ (базовые задачи) до 32 ГБ (крупнее и точнее). То есть от RTX 5060 Ti 16 ГБ до RTX 5090 32 ГБ.
Ситуация 6. Свой API для интеграции в продукты и скрипты
Кому: разработчикам и компаниям, которые встраивают ИИ в собственные сервисы.
Локальный сервер поднимает OpenAI-совместимый эндпоинт: в вашем коде достаточно подменить адрес API (base_url) — и он работает с локальной моделью без платы за токены и без внешних лимитов. Это фундамент, поверх которого строятся внутренние инструменты, автоматизации и агенты.
Модель и видеокарта: по задаче — из любой ситуации выше. API — это способ доступа к модели, а не отдельные требования к железу.
Локальный сервер поднимает OpenAI-совместимый эндпоинт: в вашем коде достаточно подменить адрес API (base_url) — и он работает с локальной моделью без платы за токены и без внешних лимитов. Это фундамент, поверх которого строятся внутренние инструменты, автоматизации и агенты.
Модель и видеокарта: по задаче — из любой ситуации выше. API — это способ доступа к модели, а не отдельные требования к железу.
Сводная таблица: задача → модель → видеокарта
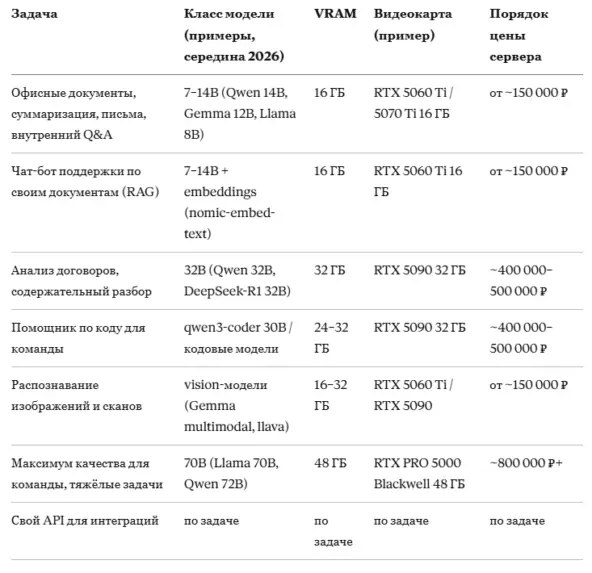
Цены ориентировочные на середину 2026 — видеопамять в этом году заметно подорожала, поэтому перед покупкой проверяйте актуальные цены. Конкретные версии моделей тоже сверяйте с текущей библиотекой Ollama: семейства (Qwen, Llama, Gemma, DeepSeek, Phi, Mistral) стабильны, а вот версии внутри них постоянно обновляются .
Немного экономики: когда это окупается
Главный денежный аргумент — не про технологии, а про арифметику. Облачные ИИ-подписки берут плату за каждого пользователя ежемесячно. Для команды в 20–50 человек это заметная сумма в год, и она растёт с каждым новым сотрудником. Локальный сервер — это разовая покупка железа, которое обслуживает всю команду без помесячной платы за каждого.
Отсюда простая логика принятия решения: чем больше у вас сотрудников, которым нужен ИИ, и чем дольше горизонт, тем быстрее один сервер окупает себя против набора подписок. Плюс к этому — то, что деньгами не измеряется напрямую, но для многих критично: данные клиентов и коммерческая тайна остаются внутри компании, что снимает риски по 152-ФЗ и по утечкам.
Стартовый порог низкий: сервер под самые массовые офисные задачи (16 ГБ VRAM) собирается примерно за 150 000 ₽ — это сопоставимо с годом-двумя облачных подписок на небольшую команду, после чего он работает без абонентской платы.
Отсюда простая логика принятия решения: чем больше у вас сотрудников, которым нужен ИИ, и чем дольше горизонт, тем быстрее один сервер окупает себя против набора подписок. Плюс к этому — то, что деньгами не измеряется напрямую, но для многих критично: данные клиентов и коммерческая тайна остаются внутри компании, что снимает риски по 152-ФЗ и по утечкам.
Стартовый порог низкий: сервер под самые массовые офисные задачи (16 ГБ VRAM) собирается примерно за 150 000 ₽ — это сопоставимо с годом-двумя облачных подписок на небольшую команду, после чего он работает без абонентской платы.
Где локальный ИИ разворачивать НЕ стоит
Честно, чтобы вы не потратили деньги зря, опишу три ситуации, когда локальный ИИ не станет лучшим решением:
Если же ваши задачи находятся в списке, который мы обсудили выше, а приватность и уход от подписок для вас важны – локальный ИИ решает вашу реальную проблему. Дальше вопрос только в том, чтобы аккуратно пройти путь от выбора железа до работающего сервера.
- Если нужен максимум качества, а приватность не критична. Для самых сложных рассуждений и творческих задач облачный фронтир сильнее. Если данные не секретные — облако проще и дешевле в моменте.
- Если задача разовая и небольшая. Разворачивать сервер ради «иногда что-то спросить» смысла нет — проще облачный чат.
- Если вы ждёте, что модель «на 8 ГБ» будет как топовое облако – к сожалению, не будет. Размер модели упирается в видеопамять, и маленькая модель на слабой карте — это базовый чат, а не замена фронтиру. Реалистично оценивайте задачу и подбирайте железо под неё.
Если же ваши задачи находятся в списке, который мы обсудили выше, а приватность и уход от подписок для вас важны – локальный ИИ решает вашу реальную проблему. Дальше вопрос только в том, чтобы аккуратно пройти путь от выбора железа до работающего сервера.
Как развернуть локальный ИИ
Весь путь — подбор железа под конкретную задачу и бюджет, установка Ollama, запуск моделей на видеокарте, веб-интерфейс с доступом по локальной сети и авторизацией для сотрудников, работа с документами и изображениями, свой OpenAI-совместимый API и перенос всего на боевой Linux-сервер — я разбираю по шагам в своём практическом курсе «Настройка своего локального ИИ сервера с нуля: Ollama + Open WebUI». Помимо теории, в курсе есть команды, чек-листы и разбор типичных ошибок.
Больше практических примеров использования ИИ для рабочих задач я публикую в своём Telegram-канале. Там же можно задать вопросы – помогу выбрать модель и оборудование для развертывания локального ИИ под вашу задачу.
Больше практических примеров использования ИИ для рабочих задач я публикую в своём Telegram-канале. Там же можно задать вопросы – помогу выбрать модель и оборудование для развертывания локального ИИ под вашу задачу.