Успешный запуск пайплайна ещё не означает, что данные корректны. Ошибки могут появиться даже в полностью отработавшем DAG и остаться незамеченными, пока не повлияют на отчёты и бизнес-метрики.
В статье Дмитрий Кузьмин, Data Engineer в финтехе и автор практических курсов по SQL, Python и Data Engineering, разбирает, как проверять качество данных на разных этапах загрузки и почему контроль должен быть частью самого пайплайна.
Представьте довольно обычную ситуацию: утром обновился дашборд, все графики на месте, но выручка почему-то не сходится с отчётом финансов. Аналитик начинает проверять формулы, Data Engineer открывает Airflow и видит полностью зелёный DAG: задачи завершились без ошибок, данные загрузились, витрина построилась. Вроде бы система сделала всё, что от неё требовалось, но цифра всё равно оказалась неправильной.
На практике такое происходит потому, что статус `success` отвечает только на один вопрос: смогла ли задача выполниться без технической ошибки. Он не подтверждает, что приехали все данные, строки не размножились после `JOIN`, внешние ключи разрешились, а повторный запуск не добавил тот же batch второй раз. Пайплайн вполне может аккуратно записать в таблицу неверный результат и остаться зелёным.
Для себя я разделяю готовность пайплайна на три уровня. Сначала проверяю техническое выполнение: запустился ли код и дошёл ли DAG до конца. Затем смотрю на структуру данных: grain, ключи, обязательные поля и дубли. И только после этого перехожу к бизнес-результату: сходятся ли количество заказов, выручка и другие показатели с источником. В учебных проектах часто останавливаются на первом уровне, хотя основные проблемы обычно начинаются дальше.
На практике такое происходит потому, что статус `success` отвечает только на один вопрос: смогла ли задача выполниться без технической ошибки. Он не подтверждает, что приехали все данные, строки не размножились после `JOIN`, внешние ключи разрешились, а повторный запуск не добавил тот же batch второй раз. Пайплайн вполне может аккуратно записать в таблицу неверный результат и остаться зелёным.
Для себя я разделяю готовность пайплайна на три уровня. Сначала проверяю техническое выполнение: запустился ли код и дошёл ли DAG до конца. Затем смотрю на структуру данных: grain, ключи, обязательные поля и дубли. И только после этого перехожу к бизнес-результату: сходятся ли количество заказов, выручка и другие показатели с источником. В учебных проектах часто останавливаются на первом уровне, хотя основные проблемы обычно начинаются дальше.
Зелёный DAG должен быть результатом проверок
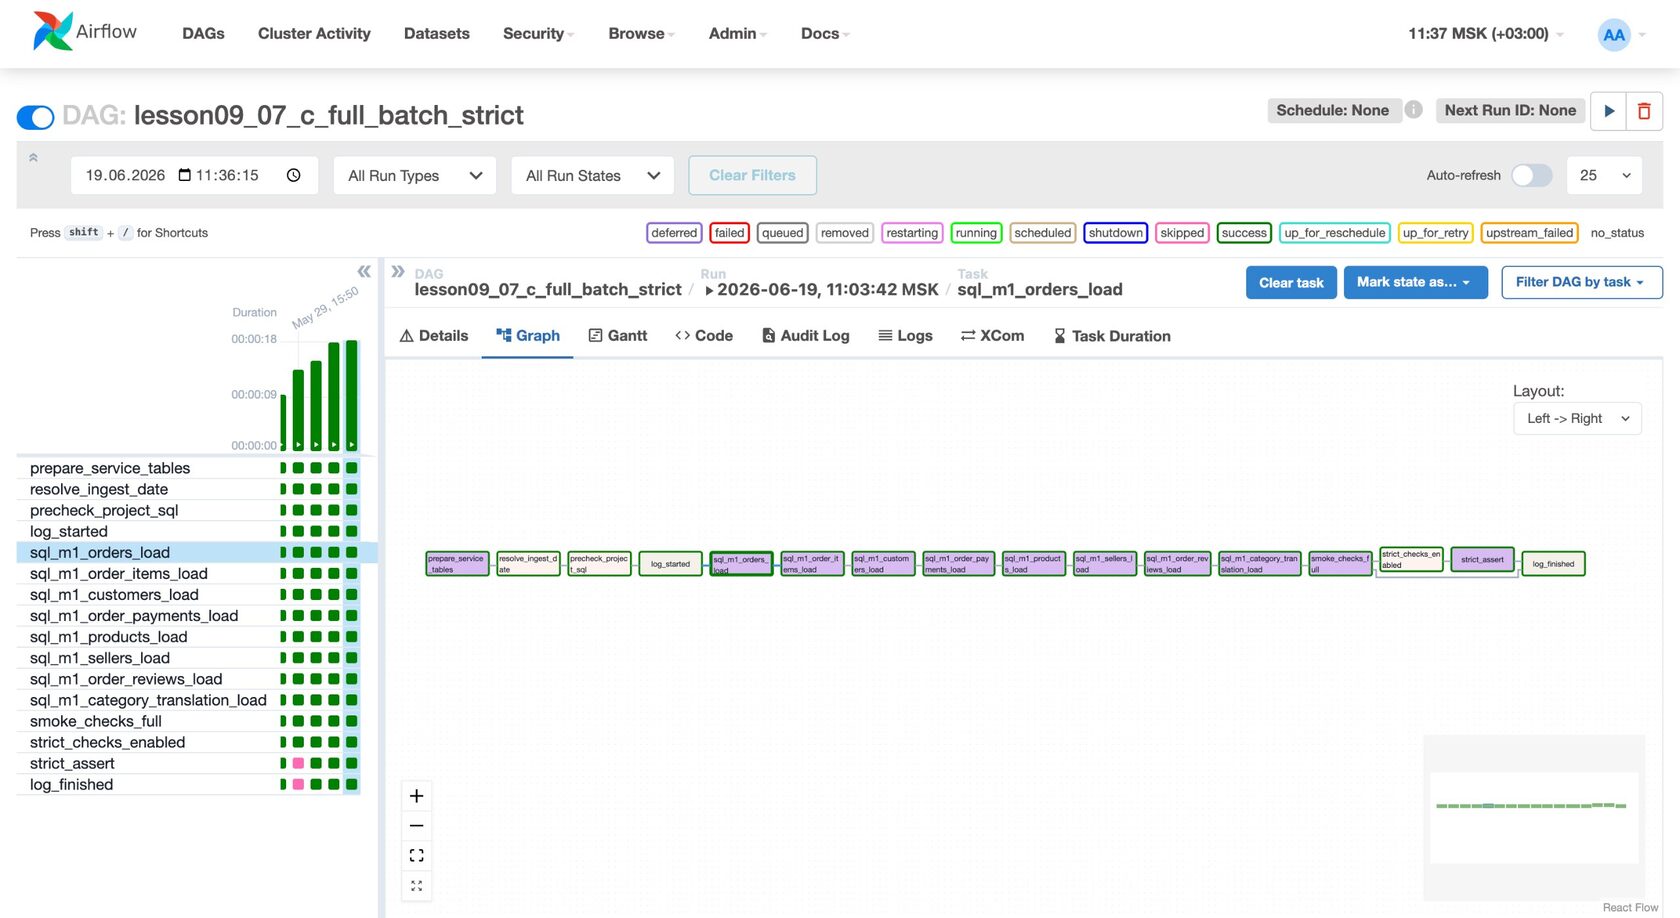
В одной из студенческих работ полный batch-процесс в Airflow действительно отработал без ошибок. На графе видны подготовка служебных таблиц, загрузка заказов, клиентов, платежей и других сущностей, после чего запускаются smoke checks, строгая проверка результата и журналирование. Такой скрин выглядит убедительно, но сам по себе он доказывает только то, что весь сценарий дошёл до последней задачи.
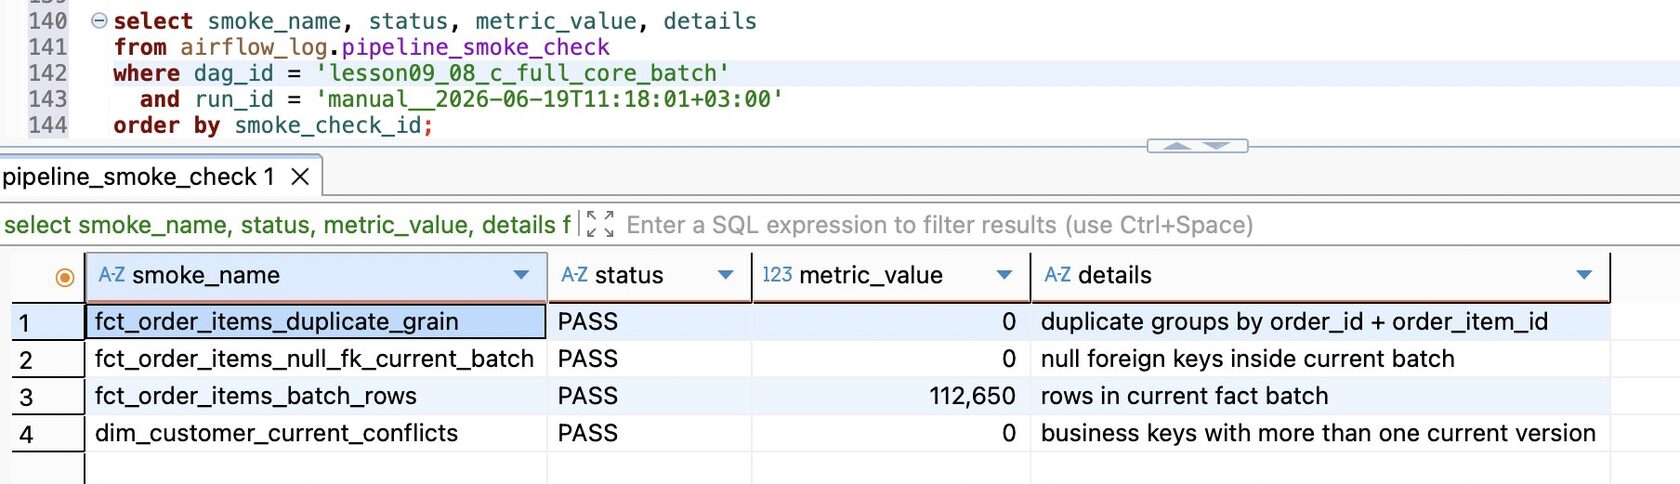
Чтобы результату можно было доверять, участник отдельно сохранил проверки текущей загрузки. В журнале видно, что в факте нет дублей по `order_id + order_item_id`, обязательные внешние ключи заполнены, у клиента не появилось несколько актуальных версий, а размер batch составляет 112 650 строк. Здесь уже есть не просто зелёный прямоугольник в Airflow, а четыре конкретных условия и измеримые значения, по которым можно понять, что именно произошло с данными.
После этого тот же batch запустили повторно. До перезапуска в таблице было 112 650 строк, повторная вставка добавила ноль, а итоговое количество осталось прежним. Это довольно простая проверка, но она отвечает на важный рабочий вопрос: сможем ли мы безопасно переиграть загрузку после сбоя или исправления кода, не задвоив данные.
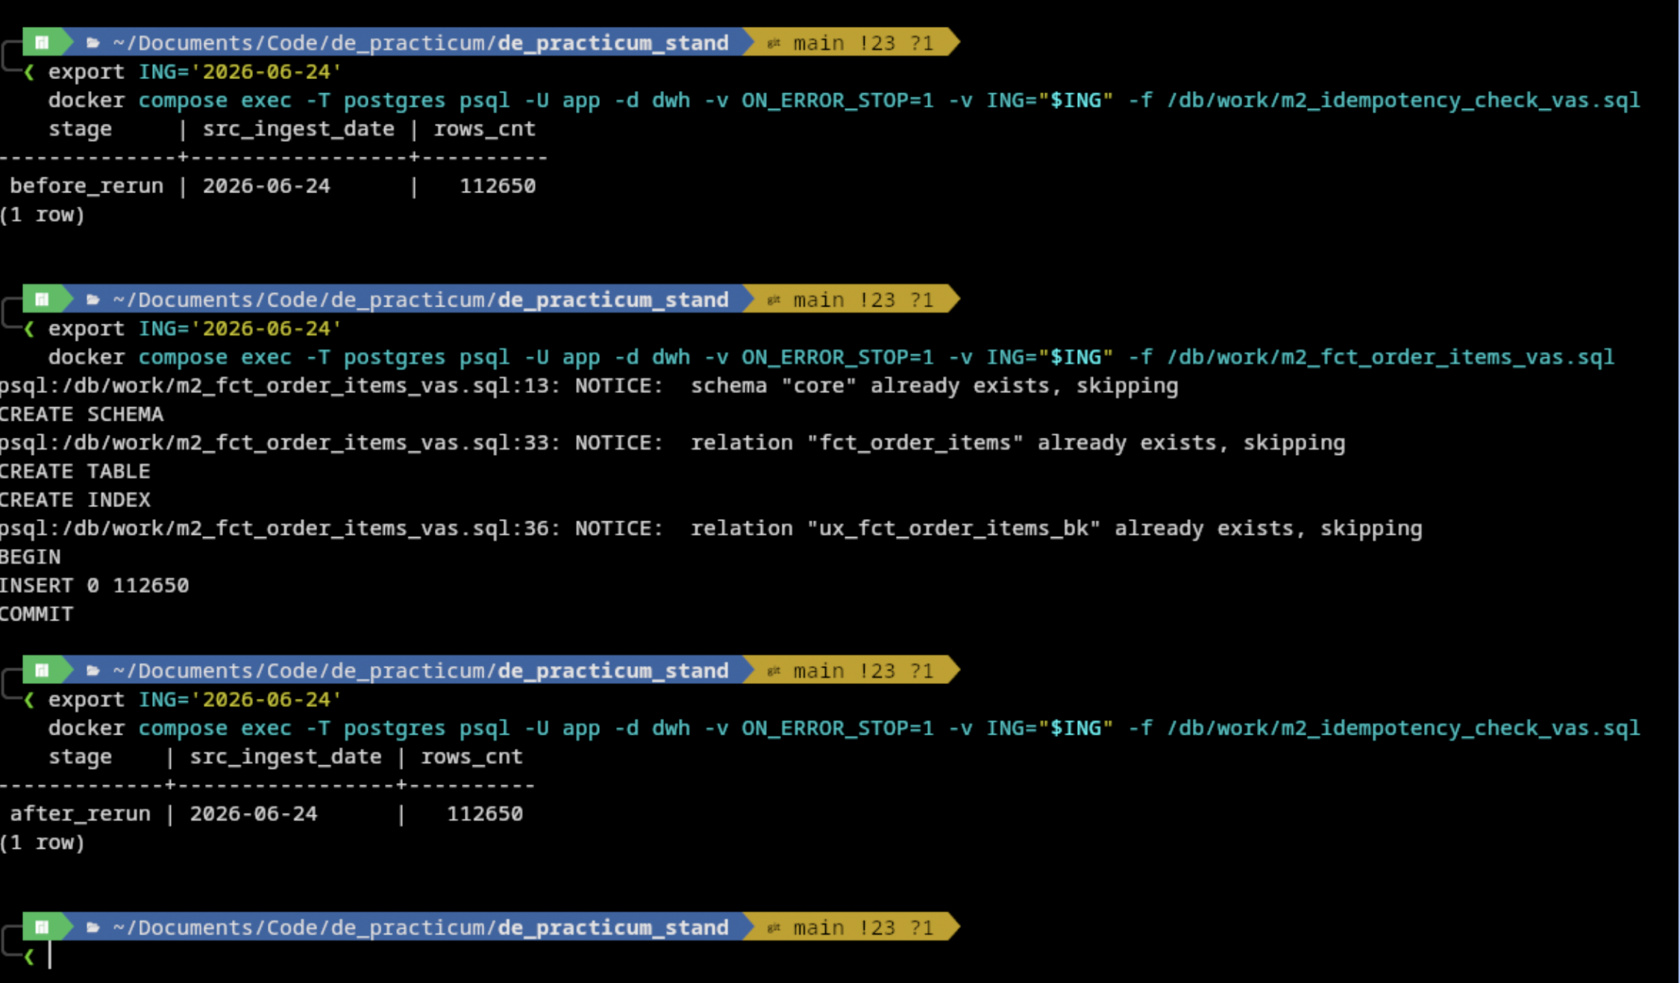
В этом и состоит принцип, который я стараюсь проводить через весь практикум: зелёный статус должен появляться после проверок, а не использоваться вместо них. Если данные не прошли обязательное условие, пайплайн должен показать проблему до того, как витрина попадёт к пользователю.
Какие проверки дают больше всего пользы
Для первого проекта не нужна большая платформа Data Quality и десятки сложных правил. Я бы начал с нескольких проверок, которые закрывают частые ошибки и при этом заставляют нормально сформулировать устройство данных.
Первое, что нужно зафиксировать, это grain таблицы, то есть что именно означает одна строка. Если в факте одна строка должна соответствовать одной позиции заказа, уникальность определяется парой `order_id + order_item_id`, и это можно проверить обычным SQL-запросом:
Первое, что нужно зафиксировать, это grain таблицы, то есть что именно означает одна строка. Если в факте одна строка должна соответствовать одной позиции заказа, уникальность определяется парой `order_id + order_item_id`, и это можно проверить обычным SQL-запросом:
select
order_id,
order_item_id,
count(*) as rows_cnt
from core.fct_order_items
group by order_id, order_item_id
having count(*) > 1;
Пустой результат означает, что повторяющихся позиций в текущей загрузке нет. Если запрос вернул строки, дальше уже нужно искать место, где данные размножились: например, одна запись факта могла соединиться сразу с двумя версиями клиента. При этом сам `JOIN` выполнится без ошибок, а итоговая сумма иногда будет выглядеть вполне правдоподобно, поэтому без отдельной проверки такую проблему легко пропустить.
Следом я бы проверил обязательные связи и ключевые бизнес-метрики. Факт может загрузиться с пустым ключом клиента или товара, а агрегированная витрина может не сойтись с детальными данными по сумме продаж, количеству заказов или возвратам. Если небольшое расхождение допустимо из-за округления или опоздавших данных, это правило нужно записать явно, иначе порог в проверке быстро превращается в случайное число, происхождение которого уже никто не помнит.
После этого стоит повторно запустить тот же batch и ещё раз посмотреть на количество строк и итоговые суммы. Первый успешный запуск показывает, что сценарий в принципе работает, но именно второй помогает проверить идемпотентность. В реальной работе загрузку приходится переигрывать после сбоя, исправления кода или повторной доставки файла, поэтому повторный запуск нельзя считать редким крайним случаем.
Следом я бы проверил обязательные связи и ключевые бизнес-метрики. Факт может загрузиться с пустым ключом клиента или товара, а агрегированная витрина может не сойтись с детальными данными по сумме продаж, количеству заказов или возвратам. Если небольшое расхождение допустимо из-за округления или опоздавших данных, это правило нужно записать явно, иначе порог в проверке быстро превращается в случайное число, происхождение которого уже никто не помнит.
После этого стоит повторно запустить тот же batch и ещё раз посмотреть на количество строк и итоговые суммы. Первый успешный запуск показывает, что сценарий в принципе работает, но именно второй помогает проверить идемпотентность. В реальной работе загрузку приходится переигрывать после сбоя, исправления кода или повторной доставки файла, поэтому повторный запуск нельзя считать редким крайним случаем.
Проверка должна оставлять след
Во время разработки можно открыть SQL-редактор, выполнить несколько запросов и убедиться, что прямо сейчас всё сходится. Проблема в том, что через неделю они останутся только в истории редактора или вообще потеряются, а вместе с ними исчезнет понимание того, что именно проверял автор.
Поэтому результаты лучше сохранять в отдельном журнале, где для каждого запуска остаются `run_id`, название условия, статус, рассчитанная метрика, детали ошибки и время выполнения. Тогда можно восстановить состояние конкретного batch и понять не только то, что пайплайн остановился, но и какое правило нарушилось. Для меня это один из признаков перехода от отдельного учебного запроса к инженерному решению: проверка становится частью процесса и срабатывает снова при следующей загрузке.
Есть ещё один момент, который часто упускают. Проверку полезно хотя бы один раз намеренно сломать и убедиться, что она действительно возвращает ошибку. Если условие всегда показывало только `PASS`, мы пока знаем лишь то, что оно не мешает пайплайну работать, но ещё не доказали, что оно поймает нужную проблему.
Поэтому результаты лучше сохранять в отдельном журнале, где для каждого запуска остаются `run_id`, название условия, статус, рассчитанная метрика, детали ошибки и время выполнения. Тогда можно восстановить состояние конкретного batch и понять не только то, что пайплайн остановился, но и какое правило нарушилось. Для меня это один из признаков перехода от отдельного учебного запроса к инженерному решению: проверка становится частью процесса и срабатывает снова при следующей загрузке.
Есть ещё один момент, который часто упускают. Проверку полезно хотя бы один раз намеренно сломать и убедиться, что она действительно возвращает ошибку. Если условие всегда показывало только `PASS`, мы пока знаем лишь то, что оно не мешает пайплайну работать, но ещё не доказали, что оно поймает нужную проблему.
Что я смотрю в студенческих работах
Когда я открываю сдачу, мне недостаточно увидеть зелёный DAG и заполненные таблицы. Сначала я пытаюсь понять, что означает одна строка в каждой ключевой таблице, как данные переходят между слоями и что произойдёт при повторном запуске. Затем смотрю, способны ли проверки вернуть ошибку, сходятся ли итоговые метрики с источником и можно ли по `run_id` восстановить ход конкретной загрузки.
Такой порядок появился не ради усложнения проекта. Человек может знать SQL, поднять контейнеры и запустить Airflow, но именно на этапе проверки результата отдельные инструменты начинают складываться в систему. У `JOIN` появляется связь с grain, у Airflow с повторным запуском, у слоёв хранилища с локализацией ошибки, а у DQ-проверок с конкретной бизнес-метрикой.
Такой порядок появился не ради усложнения проекта. Человек может знать SQL, поднять контейнеры и запустить Airflow, но именно на этапе проверки результата отдельные инструменты начинают складываться в систему. У `JOIN` появляется связь с grain, у Airflow с повторным запуском, у слоёв хранилища с локализацией ошибки, а у DQ-проверок с конкретной бизнес-метрикой.
Как это устроено на DE-практикуме
DE-практикум я строю вокруг одного сквозного проекта, чтобы Docker, Postgres, Spark и Airflow не оставались отдельным списком технологий. Участники поднимают локальное окружение, проводят данные через RAW, STG, CORE и MARTS, собирают факты и измерения, добавляют оркестрацию, проверки качества и итоговую BI-витрину. По ходу проекта у каждого инструмента появляется понятная задача, а в конце остаётся запускаемый проект и репозиторий, устройство которого можно объяснить другому человеку.
Я проверяю работы не только по принципу «запустилось или не запустилось». На ревью нужно объяснить grain, показать повторный запуск, подтвердить итоговые цифры проверками и исправить найденные проблемы. Именно эта часть отличает практикум от набора записанных уроков, поскольку участник получает обратную связь по своему решению и доводит проект до рабочего состояния.
Для входа нужна база SQL, знакомство с Python и готовность разбираться с Docker. Airflow, Spark и устройство слоёв хранилища мы собираем последовательно уже внутри проекта, поэтому заранее изучать весь DE-стек не требуется.
Если SQL уже используется в работе или учебных задачах, но отдельные знания пока не складываются в цельный пайплайн, можно посмотреть программу и входные требования DE-практикума на Stepik.
Я проверяю работы не только по принципу «запустилось или не запустилось». На ревью нужно объяснить grain, показать повторный запуск, подтвердить итоговые цифры проверками и исправить найденные проблемы. Именно эта часть отличает практикум от набора записанных уроков, поскольку участник получает обратную связь по своему решению и доводит проект до рабочего состояния.
Для входа нужна база SQL, знакомство с Python и готовность разбираться с Docker. Airflow, Spark и устройство слоёв хранилища мы собираем последовательно уже внутри проекта, поэтому заранее изучать весь DE-стек не требуется.
Если SQL уже используется в работе или учебных задачах, но отдельные знания пока не складываются в цельный пайплайн, можно посмотреть программу и входные требования DE-практикума на Stepik.